문제
갑자기 운영 중이던 서버에서 여러 개의 메일이 발송되어서 놀랐던 적이 있습니다.
잘 운영되다가 갑자기 새벽 시간에 이렇게 서버에서 에러가 발생한다는 게 신기했기에, 최근에 SEO를 손봐서 봇이 접근한 걸까라는 의문이 들기도 했죠.
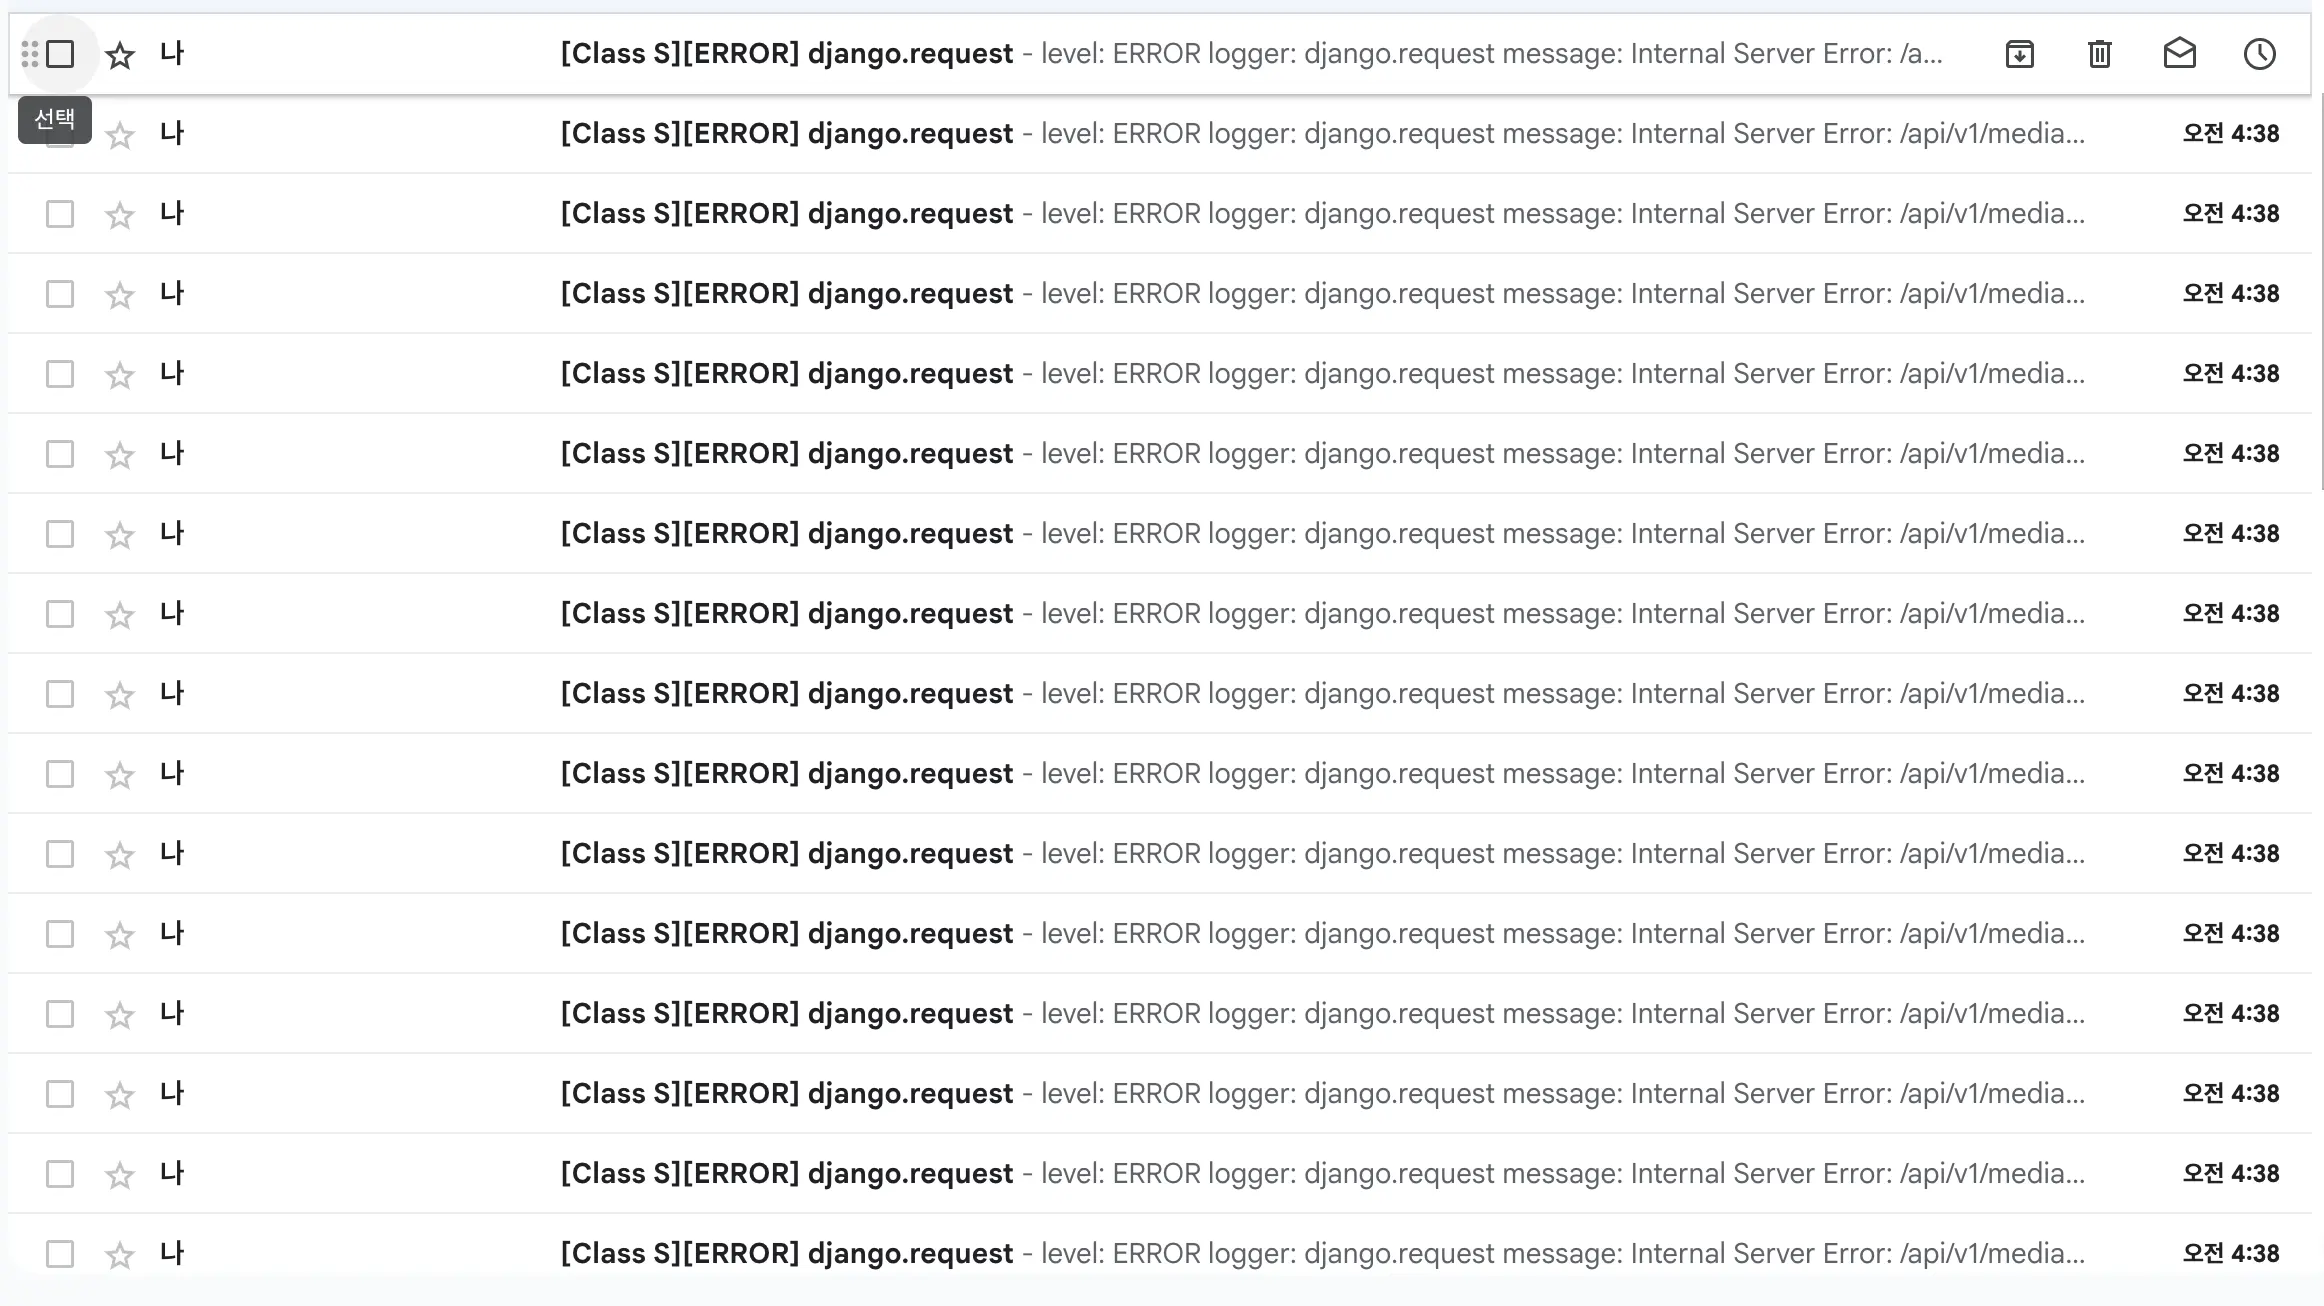
아래는 내용의 일부입니다. too many clients already로 PG에서 허용된 connection보다 더 많은 개수가 부여된 걸 알 수 있는데 여기서 의문이 들었죠, 내 서비스는 지금 일일 사용자가 10명도 안 되는데?
timestamp: 2026-09-04T04:39:00.499+09:00
logger: django.request
level: ERROR
message: Internal Server Error: /api/v1/media/courses/121
FATAL: sorry, too many clients already
분석
다시 위 문구를 보면 too many clients already는 Postgres가 max_connections 한도로 새 커넥션을 거부한 거죠.
같은 시각 logs/access.log에는 0.3초 안에 GET이 26개 들어왔고, 그중 courses/121이 56362ms(약 56.36초) 기다리다 500을 낸 걸 확인해 볼 수 있었습니다. 성공과 실패 모두 IP가 172.18.0.4이고 user_id는 없었죠.
로컬 runserver에서는 같은 Django 코드가 멀쩡했습니다. 깨진 쪽은 배포 서버이므로 메모리 누수나 커넥션 풀, 동시성 모델 이슈로 추측이 되었죠.
서버 변경
배포 API는 gunicorn이고, WSGI 서버입니다.
WSGI는 Python 웹 앱과 웹 서버가 요청을 주고받는 표준 인터페이스이고,
Class S에서는 config.wsgi:application을 워커 프로세스로 띄웁니다.
이전에는 --worker-class를 생략해서 gunicorn 기본값인 sync로 워커 하나가 요청 하나가 끝날 때까지 붙잡고, 워커 3개면 동시 요청도 3개인 방식으로 진행되었습니다.
gunicorn config.wsgi:application --bind 0.0.0.0:8000 --workers 3 --timeout 120
하지만 이후에 SSE 알림이 생기면서 긴 Redis 대기 연결과 기존 API가 한 서버에 같이 들어왔습니다. SSE는 Server-Sent Events이고, HTTP 응답을 닫지 않은 채 서버가 이벤트를 계속 밀어 넣는 방식입니다.
그래서 기존 sync 워커에서는 그 긴 연결이 워커 하나를 끝까지 붙잡았기에 이를 gevent로 바꿨을 때 이득이 커졌다고 판단되었고, gunicorn에서는 gevent를 쓸 수 있는 옵션을 제공해서 이를 적용했습니다.
gunicorn config.wsgi:application --bind 0.0.0.0:8000 \
  --worker-class gevent \
  --workers 2 \
  --timeout 120
이 명령에는 --worker-connections가 없습니다. gunicorn 26.0의 gevent 기본값은 워커당 1000이라, 워커 2개면 이론상 2000개 요청을 동시에 붙잡을 수 있고 Django가 연 Postgres 소켓도 그만큼 늘어날 수 있습니다.
하지만 에러가 발생했을 당시 Postgres max_connections는 100개로 설정되어 있습니다.
아래처럼 서버가 변경되면서 해당 문제가 발생하게 될 원인을 제공하게 되었죠.
| 구분 | 기동 | 동시 요청 | Postgres 슬롯 |
|---|---|---|---|
| 이전 | gunicorn sync, 워커 3 | 3 | 이미지 기본 약 100 |
| 이후, 핫픽스 전 | gunicorn gevent, 워커 2, connections 미지정 | gunicorn 기본 워커당 1000, 이론상 2000 | 이미지 기본 약 100 |
gunicorn, gevent, greenlet
다음 3개는 묶어서 보는 게 편합니다. 에러 원인을 이해하려면 이 계층만 알면 됩니다.
- gunicorn은 Django 앱을 워커 프로세스로 띄우는 WSGI 서버입니다.
--workers 2면 OS 프로세스가 2개입니다. - gevent는 greenlet 위에 이벤트 루프와 네트워크 I/O를 올린 라이브러리입니다. 소켓에서 응답을 기다리는 동안 다른 greenlet으로 실행을 넘겨, 한 워커가 여러 요청을 겹칠 수 있습니다.
- greenlet은 요청 하나가 쓰는 실행 흐름입니다. 스레드가 아니라, Python이 같은 OS 스레드를 나눠 쓰는 경량 단위입니다.
Gunicorn Master
│
├─ Worker Process
│   └─ Thread
│       ├─ Greenlet
│       ├─ Greenlet
│       └─ Greenlet
│
└─ Worker Process
    └─ Thread
        ├─ Greenlet
        ├─ Greenlet
        └─ Greenlet
문제 원인 분석
강좌 데이터를 부를 때 해당 API의 비즈니스 로직에서 실패한 게 아니고 Postgres가 max_connections 한도로 새 연결을 거부하게 되었고, 같은 시각 카탈로그와 다른 강좌 상세도 같이 500이 났습니다. 당시 Postgres 기본 max_connections는 100이었습니다.
실제로 관련 로그나 GA를 보면 일일 사용자가 10명도 안 되는데 슬롯이 찬 걸 볼 수 있었습니다. DB 슬롯이 사람 수가 아니라 열려 있는 TCP 커넥션 수이기 때문에 발생한 것이고, 이때 구조에서는 한 커넥션이 오래 유지되었기에 이 이슈가 발생한 걸로 보였습니다.
추측되는 에러는 크게 4가지였습니다.
gunicorn gevent와 커넥션 재사용입니다.
API는--worker-class gevent --workers 2이고,--worker-connections를 안 두면 워커당 동시 상한이 1000입니다. DjangoCONN_MAX_AGE는 기본 60이라 요청이 끝난 뒤에도 소켓을 최대 60초 붙잡습니다.sync워커 몇 개일 때와는 규모가 달라지게 되는 요소가 있었습니다.알림 SSE입니다.
알림 기능은 로그인한 탭의 스트림은StreamingHttpResponse로 Redis를 구독하고,IsAuthenticated가 유저를 DB에서 읽은 뒤 스트림이 끝날 때까지 요청이 살아 있습니다. Django는 요청이 끝나야 커넥션을 정리하므로, 탭이 살아 있을 경우 계속 커넥션이 유지되는 건 그대로 뒀습니다. 이번 새벽 로그에는user_id가 없어서, 2번은 간접적인 영향으로 이번 에러의 원인은 아닌 걸로 추측됩니다.같은 Postgres를 여러 프로세스가 사용합니다.
max_connections는 Postgres 프로세스 하나의 한도인데, 현재 구조는 하나의 서버에서 gunicorn API, 뉴스레터 cron(매일 09:00), SSE가 붙습니다.Next의 sitemap 생성 방식
새벽 4시에 터진 직접 경로는 사람이 강좌 24개를 연 게 아닙니다.dynamic = "force-dynamic"일 때 Next는/sitemap.xml을 만들기 위해 백엔드에 요청을 합니다. 이 부분에서 부담이 발생할 수 있습니다.
현재 로그를 보면 4번이 트리거로 가장 크게 요청이 발생했습니다.
4번과 같은 sitemap 요청이 다른 요청들과 겹쳤을 때 터진 걸로 추측이 됩니다. Next에서는 sitemap.xml을 만들기 위해서 사용 중이지만 실제 서비스 로직 API를 부르므로 백엔드에 큰 부담을 주게 되었습니다. 특히 영상에 관련된 태그도 사이트맵에 넣다 보니 태그를 얻기 위해 상세 페이지에 대한 API를 요청해서 발생했습니다.
즉 4번에서 사이트맵을 생성하다가 태그를 찾기 위해 상세 페이지 API를 과도하게 호출한 것이 트리거이고, 1번의 gevent 상한과 CONN_MAX_AGE가 그 요청을 PG의 max_connections보다 크게 만든 게 원인이었죠.
2026-09-04T04:38:06.773  GET /api/v1/media/courses/118
2026-09-04T04:38:06.800  GET /api/v1/media/courses/120
...
2026-09-04T04:38:06.881  GET /api/v1/media/catalog
...
2026-09-04T04:38:07.074  GET /api/v1/media/courses/121
2026-09-04T04:38:07.235  GET /api/v1/media/courses/93   200  556ms  ip=172.18.0.4
2026-09-04T04:39:03.053  GET /api/v1/media/courses/121  500  56362ms  ip=172.18.0.4

logger: django.request
message: Internal Server Error: /api/v1/media/courses/121
FATAL: sorry, too many clients already
해결
동시에 붙잡을 수 있는 greenlet 수를 Postgres 슬롯 아래로 안전 마진을 넣어 줄이고, 사이트맵이 태그 URL을 모으려고 강좌 상세를 한꺼번에 요청하던 경로를 없앴습니다.
gevent greenlet 상한
gunicorn 26.0의 gevent 워커는 --worker-connections를 생략하면 워커당 1000입니다. 배포 명령에는 환경 변수 기본값 25를 넣었습니다. ${GUNICORN_WORKER_CONNECTIONS:-25}는 gunicorn 기본값이 아니라, 값이 비었을 때 셸이 25를 넣는 설정입니다.
gunicorn config.wsgi:application --bind 0.0.0.0:8000 \
  --worker-class gevent \
  --workers 2 \
  --worker-connections "${GUNICORN_WORKER_CONNECTIONS:-25}" \
  --timeout 120
동시 요청 상한은 workers × worker-connections입니다. 워커 2개면 50개입니다.
수정 전 버전에서는 gunicorn gevent 기본은 워커당 1000이라, 이론상 2000개 greenlet이 max_connections 100을 넘을 수 있었습니다.
같이 CONN_MAX_AGE를 60에서 0으로 내렸습니다. gevent에서는 남겨 둔 소켓이 다른 greenlet으로 넘어가기 쉬워서 요청이 끝나면 소켓을 닫게 했습니다. 요청마다 소켓을 열고 닫으므로 연결 오버헤드는 늘어납니다. 지금 트래픽에서는 슬롯을 붙잡지 않는 쪽이 우선이었죠.
같은 핫픽스에서 알림 스트림은 인증이 DB를 쓴 뒤 connections.close_all()로 소켓을 놓고 Redis 루프에 들어가게 했습니다. 유휴 탭이 Postgres 슬롯을 붙잡지 않게 하기 위함입니다.
| 항목 | 수정 전 | 수정 후 |
|---|---|---|
--worker-connections | 미지정, 워커당 1000 | 25 |
| 동시 greenlet | 이론상 2000 | 50 |
CONN_MAX_AGE | 60초 재사용 | 0, 요청 종료 시 닫음 |
지금 세팅 값은 t3.small 사양 기준으로 안전값이며, 앞으로 운영 중에 또 too many clients가 발생하면 조절해야겠습니다.
사이트맵 전용 태그 API
수정 전 sitemap.ts는 카탈로그에서 모은 강좌 최대 24개에 대해 Promise.all로 GET /api/v1/media/courses/{id}를 치고, 응답의 videos[].tags에서 값을 긁었습니다. 새벽 로그의 courses/118, courses/120, courses/121이 이 경로입니다. 사람이 상세를 연 게 아니라, 태그 URL을 만들기 위한 부가 요청이었습니다.
공개된 강좌 영상에 붙은 태그만 name과 slug로 돌려주는 GET /api/v1/media/tags를 추가해서 Next 사이트맵을 생성할 때 API 부담을 줄였습니다.
| 사이트맵 생성 | 수정 전 | 수정 후 |
|---|---|---|
| 카탈로그 | GET /catalog, 최대 3페이지 | 동일 |
| 태그 | 강좌 상세 최대 24개 병렬 | GET /tags 1회 |
VOD 서비스의 사이트맵
사이트맵 경로를 고친 김에, 다른 VOD와 강의 플랫폼은 URL 목록을 어떻게 나눠 주는지도 궁금해졌습니다.
사이트맵 프로토콜은 파일 하나당 URL을 최대 5만 개, 비압축 기준 50MB까지 담을 수 있습니다. 한도는 sitemaps.org 프로토콜에 적혀 있고, Google Search Central도 같은 숫자를 적어 둔 걸 확인해 볼 수 있죠.
카탈로그가 그보다 커지면 메인 사이트맵에 하위 사이트맵 주소만 모아 관리합니다. 이번에 본 서비스들은 이 구조를 쓰고 있었습니다.
넷플릭스 메인 사이트맵은 https://www.netflix.com/sitemap/index로, 인덱스는 작품마다 /sitemap/title/{id} 하위 파일을 가리키고, 그 안에는 같은 작품의 국가와 언어 URL이 hreflang으로 묶여 있습니다.
- ※ hreflang: 다국어 또는 다지역 웹사이트에서 Google에 페이지의 어떤 언어 및 국가 버전을 어느 사용자에게 보여줄지 알려 주는 기술적 SEO 기법
라프텔은 메인 사이트맵 아래에 테마, 아이템, 태그를 두고, 회차는 월별 XML로 나눠 관리하고 있었습니다.
유튜브도 사이트맵이 있지만 인덱스가 가리키는 건 Kids, Jobs, Creators 같은 제품과 정책 페이지이고, /watch URL 전체는 공개 사이트맵에 없습니다.
인프런은 강좌, 유저, 리뷰, 태그, 질문을 종류별로 쪼개고, 파일이 커지면 sitemap-reviewDetail-0.xml처럼 번호를 붙입니다.
| 서비스 | 인덱스 | 하위 분할 |
|---|---|---|
| 넷플릭스 | /sitemap/index | 작품 ID별, 지역 hreflang |
| 라프텔 | /sitemap.xml | 테마, 태그랑 월별로 구분 |
| 유튜브 | /sitemaps/sitemap.xml | 제품과 정책 페이지만, 시청 URL은 없음 |
| 인프런 | CDN sitemap.xml | 강좌, 유저, 리뷰, 태그 등 타입별 |
카탈로그가 커지면 사이트맵을 인덱스로 나누는 쪽이 프로토콜 특징에 맞습니다. 하지만 아직 이 프로젝트의 콘텐츠는 많지 않고, 발행 편의성으로 보면 지금 구조가 좋아 보였습니다. 나중에는 업로드 시 사이트맵이 업데이트되는 파이프라인을 고려해 볼 수도 있겠지만, 지금 구조에서는 과해 보이네요.